推理模型为何答对了还在想:LoCo教它适时收尾
腾讯与西安交大的LoCo从模型自身思维链中找出过度思考的时刻,用DPO教它在此收尾。

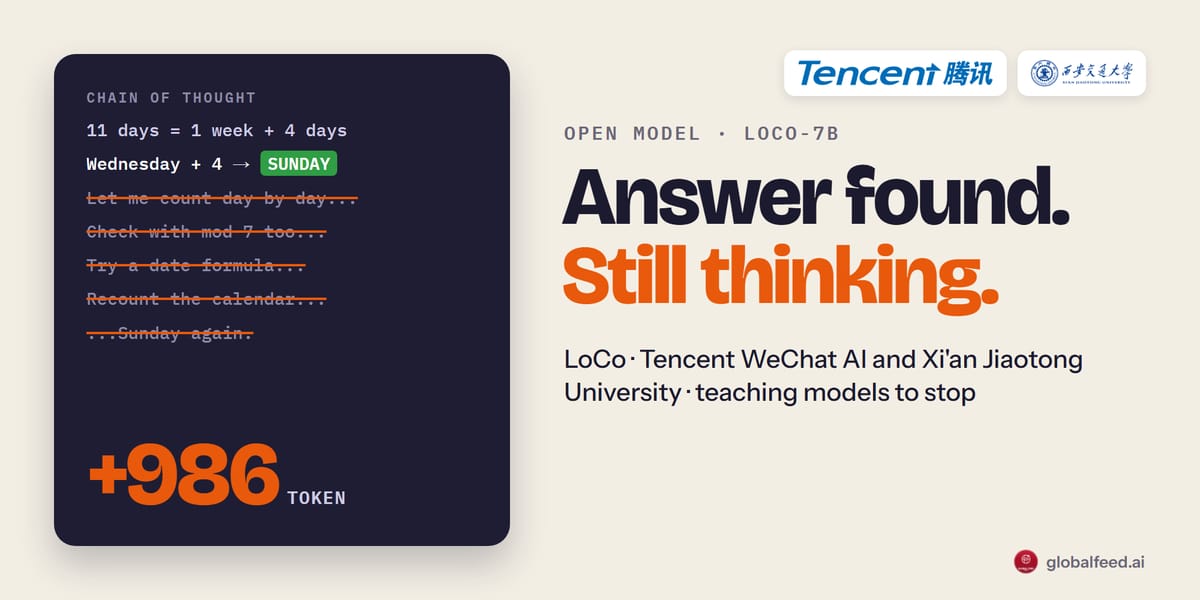
问AI:"2030年7月3日是星期三,7月14日是星期几?"DeepSeek的70亿参数推理模型几步就算出星期日,然后逐日核对、再用模7验证,接着又尝试日期公式、放弃、重新数日历。论文中的这个真实例子里,答案早已得出,模型又写了986个token,而从同一处只需212个。腾讯微信AI与西安交通大学的研究人员于11月3日发布的LoCo方法,就是教模型识别这个该停下的时刻。LoCo-7B以MIT许可在Hugging Face开放下载。
据论文,在五个数学基准上回答长度缩短41.7%至45.4%,准确率持平或提升;只用数学题训练的模型写代码时也缩短23.4%至36.3%,三个代码基准的准确率均持平或提升。
如何工作
第一步,把模型自己的思维链按段落切成步骤,记录每个token最高预测概率,求出每步"置信度"及其相对上一步的"波动"。置信度处于最低25%、波动处于最高25%的步骤成为候选,再由Qwen3-30B裁判判定下一步是"过度思考"、"正常"还是"给出答案"。第二步,在确认的位置冻结思维,让模型从同一处续写8次,取最短的正确续写。第三步,把"短而正确的结尾"作为优选、原来的长续写作为拒绝,用DPO训练。由于开头相同,模型学到的只是"在这里收尾",难题上仍能继续思考。
如何训练
基座为DeepSeek-R1-Distill-Qwen-7B,数据全部来自模型自身输出:math14k数学集的14,027道题,每题采样3次取最短正确解;每个位置续写8次,至少节省300个token才保留,每题最多3对。训练使用LoRA(秩256,alpha 512),只作用于注意力q/k/v/o投影,2个epoch,学习率1e-5,DPO beta 0.1,在4张Nvidia H20上完成。消融实验显示:整条解答层面的长短配对只缩短5%至16%;由GPT-5.4代写续写效果较弱;随机选取截断点则准确率下降。
如何试用
模型约76亿参数,bfloat16下约需15GB显存,可用vLLM运行(温度0.6,top-p 0.95)。GitHub仓库提供从数据构建到训练评测的全部代码,模型与代码均为MIT许可,允许商用。所有结果均为作者自测,尚无独立评估。
来源: LoCo-7B模型卡, 论文, GitHub, 基座模型