لماذا يواصل نموذج الاستدلال التفكير بعد الجواب: طريقة LoCo تعلمه التوقف
طريقة LoCo من تينسنت وجامعة شيآن جياوتونغ تكتشف لحظة التفكير الزائد من مسار النموذج نفسه وتعلمه بطريقة DPO أن ينهي عندها.

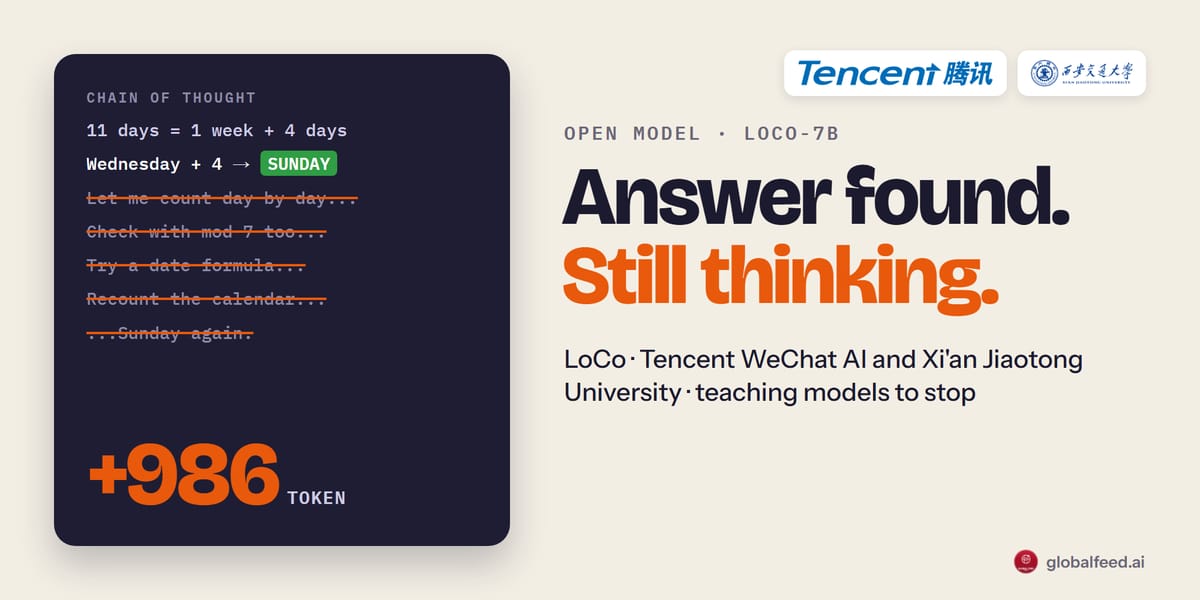
اسأل نموذج ذكاء اصطناعي: "إذا كان 3 يوليو 2030 يوم أربعاء فما هو يوم 14 يوليو؟" يصل نموذج الاستدلال من DeepSeek بحجم 7 مليارات معامل إلى الجواب في بضع خطوات: الأحد. ثم يعدّ الأيام واحدًا واحدًا، ويتحقق مرة أخرى بالحساب المعياري، ثم يجرب صيغة للتاريخ ويتركها ويعيد عدّ التقويم. في هذا المثال الحقيقي من الورقة البحثية كتب النموذج 986 رمزًا إضافيًا بعد أن وجد الجواب، بينما كانت 212 رمزًا تكفي من النقطة نفسها. طريقة LoCo التي نشرها في 3 نوفمبر باحثون من فريق WeChat AI في تينسنت وجامعة شيآن جياوتونغ تعلّم النموذج التعرف على هذه اللحظة بالذات، والنموذج LoCo-7B متاح على Hugging Face برخصة MIT.
وبحسب الورقة تقصر الإجابات في خمسة اختبارات رياضيات بنسبة 41.7% إلى 45.4% مع ثبات الدقة أو تحسنها، والنموذج الذي درّب على مسائل رياضيات فقط يفكر أيضًا أقل بنسبة 23.4% إلى 36.3% عند كتابة الشيفرة.
كيف تعمل
أولًا يقسم الباحثون سلسلة تفكير النموذج إلى خطوات ويقيسون ثقة النموذج في كل خطوة وتذبذبها مقارنة بالخطوة السابقة، فتصبح الخطوات منخفضة الثقة وعالية التذبذب مرشحة، ثم يحكم نموذج أكبر هو Qwen3-30B إن كانت الخطوة التالية تفكيرًا زائدًا. ثانيًا تُجمّد سلسلة التفكير عند تلك النقطة ويكمل النموذج منها ثماني مرات، ويُختار أقصر إكمال صحيح. ثالثًا يُدرّب النموذج بطريقة DPO على تفضيل النهاية القصيرة الصحيحة على النهاية الأصلية الطويلة، ولأن البداية مشتركة يتعلم النموذج قرار التوقف في هذه النقطة فقط ويحافظ على قدرته على مواصلة التفكير في المسائل الصعبة.
كيف درّب
النموذج الأساسي هو DeepSeek-R1-Distill-Qwen-7B، وكل بيانات التدريب من إنتاجه الذاتي: 14,027 مسألة رياضيات، وثلاث محاولات لكل مسألة، ويُحتفظ بالزوج فقط إذا وفر 300 رمز على الأقل. التدريب بمحوّل LoRA برتبة 256 على طبقات الانتباه، لدورتين، على أربع بطاقات Nvidia H20. وأظهرت التجارب أن مقارنة الحلول الكاملة لا تختصر إلا 5% إلى 16%، وأن اختيار نقاط القطع عشوائيًا يخفض الدقة. وسبق أن عرضنا دراسة Goodfire عن الكلمات المتفرعة في مسار الاستدلال.
كيف تجربه
يحتاج النموذج نحو 15 غيغابايت من ذاكرة بطاقة الرسوميات بدقة bfloat16 ويعمل عبر vLLM. يضم مستودع GitHub كل الشيفرة من بناء البيانات إلى التدريب والتقييم، والنموذج والشيفرة برخصة MIT التي تسمح بالاستخدام التجاري. كل النتائج من قياسات المؤلفين، ولم يُنشر تقييم مستقل بعد.
المصادر: بطاقة نموذج LoCo-7B, الورقة, GitHub, النموذج الأساسي